Imagination将AI加速能力集成至GPU,助力IP业务增长
2024年9月21日,Imagination Technologies正式公布了其E系列GPU IP的首轮实测性能指标及演示成果,同时推出了名为NSR(神经超分辨率)的新兴技术。
不同于英伟达或AMD直接向市场出售成品GPU的做法,Imagination的定位是GPU架构IP授权商——它向客户提供可许可使用的处理器微架构、配套软件及开发工具包,再由客户基于这些基础自行设计和制造芯片。
此次推出的NSR技术,核心目标是在GPU继续胜任图形渲染与通用并行计算的前提下,进一步增强其对人工智能工作负载的处理能力。
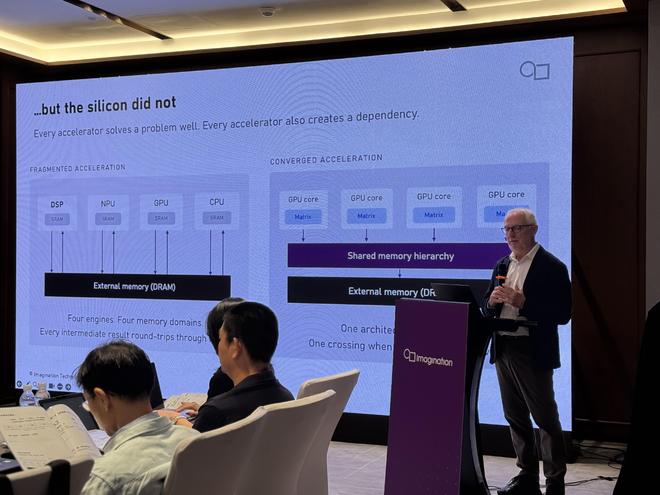
在常规SoC设计中,CPU、GPU、NPU和DSP各司其职、分工明确。例如,图形管线输出的画面若要交由NPU进行AI超分处理,中间数据往往需要先落盘到外部存储器,再由另一个处理单元重新加载。而Imagination的方案是将矩阵运算引擎直接嵌入GPU统一着色器集群的邻近位置,使图形计算与AI推理尽可能共享同一条数据通道。
基于这一思路,Imagination把矩阵加速模块整合进了GPU核心内部,让不同类型的计算任务共享同一套内存子系统、调度器和软件框架。公司期望通过这种方式削减芯片内部各加速器间的数据搬移开销,同时也帮助客户省去维护多套异构软件栈的额外负担。
Imagination首席执行官Markus Mosen(图片来源:界面新闻)
E系列架构于去年首次对外展示,本次公开的具体数据进一步明确了其产品层级。据Imagination介绍,目前已有数家合作伙伴获得了E系列的IP授权,预计首批搭载该架构的芯片将于2026年下半年完成流片验证。
Imagination给出的基准测试数据显示,在典型的端侧大语言模型场景中,E系列的预填充(Prefill)阶段吞吐量相比前代D系列提升了4.7倍。
具体来看,以Qwen 3.5 4B稠密模型为测试对象,一颗主频1.5GHz的四核EXD-64-2048芯片,在W4A16量化精度、输入与输出序列长度均为1500 token的设置下,首个token的延迟为0.2秒,持续解码速率达到每秒150个token。
图形渲染依然是E系列的核心应用场景之一。该架构兼容DirectX 12 Feature Level 11_0、Vulkan以及OpenCL标准。官方测试结果表明,在真实游戏工作负载下,E系列相较上代同级产品峰值性能提升可达54%,能效比(每瓦性能)最高改善39%;四核版本在运行部分PC级游戏时帧率可以稳定突破60FPS。
Imagination将E系列的发布置于"融合加速"这一行业大背景下加以阐释。当前,智能手机、智能座舱、机器人及工业控制设备都需要在同一颗芯片上兼顾感知采集、推理判断、逻辑决策与画面渲染,而这些功能传统上分散在多颗不同的处理器上。每新增一种专用加速单元,整个系统层面就需要额外配备对应的驱动程序、编译工具链、安全隔离机制以及长期运维保障。
CEO Markus Mosen形象地将不同计算模块之间频繁的数据交互比喻为"边境税"。这笔隐性成本既体现在跨单元传输带来的功耗与延迟损耗上,也反映在芯片设计方为支撑多条工具链和多套运行时环境所付出的工程人力。
这正是GPU在边缘AI领域具备的产业意义所在:倘若GPU能分担一部分AI推理任务,芯片设计者便能提高现有硬件资源的复用率,减少独立加速器间的来回通信,并且沿用此前已积累的软件资产。
当然,通用性并不等于GPU将取代全部NPU。对于结构固定的模型或高度特化的算子,专用加速器依然更具优势;与此同时,CPU仍将承担模型编排、函数调用及全局数据管理等职责。
真正的较量恐怕还是落在软件生态层面。Imagination正将其深度优化的Llama.cpp推理后端回馈给上游开源社区,未来还打算推出对原生PyTorch和ONNX Runtime的支持。
不过公司也不讳言,从CUDA生态迁移到其他架构不可避免地涉及大量代码重写与适配工作;开源驱动的成熟度往往取决于客户的芯片实物和开发板是否到位;若客户不愿分享底层硬件细节,面向特定终端的深度调优也将受限。首席营收官Jake Kochnowicz在接受界面新闻等多家媒体采访时直言:"在实际落地部署中,软件才是真正的最大开支,而非硬件本身。"
就Imagination而言,中国市场承载着特殊战略分量。一方面,国内芯片企业与终端品牌急需成熟的GPU IP来支撑桌面显卡、车载芯片、机器人控制器及边缘算力产品的研发;另一方面,中国客户对更高性能指标和更完备功能覆盖的诉求,也在反向塑造着Imagination的产品演进方向。
Jake对此评价道:"中国在GPU方面的需求规模无疑是庞大的。聚焦到我们提供的GPU IP,最直观的感受就是中国市场推动节奏更快、性能要求更高、功能集更全,确实在不断拓展GPU IP的能力上限。"
对于中国本土芯片设计公司来说,引入GPU IP的核心价值在于大幅压缩从底层微架构到可交付产品的研发周期,同时又能在芯片规格定义、内存体系选型及应用场景规划上保有充分的话语权。在此前提下,企业在芯片版图实现、驱动层适配、整机组装调试以及开发者生态培育等环节拥有更大的自主决策空间。
Imagination在今年对中国区的组织架构和销售体系进行了调整。Markus Mosen向界面新闻透露,年内公司已成功签约一家全新的战略级客户,另有一家合作正处于推进阶段。新上任的公司执行副总裁兼中国区总经理谢巍则补充说,基于其GPU IP的中国桌面级终端产品,今年的累计出货量已逼近100万台大关。
谢巍还表示,展望未来,公司将持续关注中国桌面GPU市场的发展动态,并将目光投向边缘AI、智能汽车以及具身智能机器人等新兴应用领域。