超70家训练场、千万小时数据:具身智能"新基建"全面提速
在上海浦东新区的一家数据采集车间内,几十个人形机器人日复一日地执行着相同序列的操作:拾起一只杯子、将其放置到目标点位、接着取下一件物品。操作员借助远程操控终端反复修正机器人的运动路径,与此同时,摄像头捕捉的画面、各关节的角度读数、力矩传感器的回传数值等信息源源不断地流入后端服务器。
几乎在同一时间,成都、无锡、南昌、苏州、天津、北京、深圳等数十座城市里,几乎一模一样的画面正在同时展开。
这些看上去单调乏味的"机械重复",恰恰构成了当前中国具身智能领域最核心的一项底层工程。
中国信息通信研究院不久前公布的《具身智能训练场研究报告(2026年)》,首次全面梳理了这一赛道的"存量资产":到2026年6月末,全国各地已投入运营的具身智能训练场(即数据采集中心)突破70座,另有46座处于施工或规划状态,业务触角延伸至18个省、自治区及直辖市。
如果前两年这个行业的主题词还是"造硬件、练模型",那这份报告释放的方向感十分鲜明:具身智能正迈入"数据基础设施建设"的新周期——谁能建立起面向真实物理环境的大规模数据生产能力,谁就能拿到下一阶段博弈的通行证。
信通院报告亮出底牌:一场围绕"数据底座"的竞争已然打响
整个赛道为何骤然掀起"抢数据"的风潮?根源在于一个直白的认知:要让机器人真正做到"能上手干活",光靠"见过"远远不够,必须靠"亲手做过"来积累经验。
大语言模型之所以起步顺利,是因为人类数千年的书写遗产加上全球六十多亿互联网用户,早已替它备好了大约300万亿词元的现成语料库。然而机器人所依赖的视觉特征、肢体动作、关节力矩、力觉与触觉等多通道交互信息,在此之前从未被人系统化地记录下来,不可能直接从网络上抓取,唯有从零起步、逐帧逐条地去生成。
哪怕仅仅是一个简单的抓取过程,其中交织着视觉识别、三维空间建模、动作策略制定、末端轨迹调控、接触力反馈以及成功与否的判定等多个环节,这些数据必须让机器人置身于真实的物理空间中,经由海量实操不断沉淀。
信通院报告用一组推演揭示了供需之间的鸿沟:倘若机器人要迎来属于自己的"ChatGPT拐点",所需训练数据量约为1.1万亿token。假如全部依赖实体机器人采集,大约需要21200台机器不停运转整整一年,才能产出千万小时量级的有效样本。而放眼全球,现阶段可调用的高质量实机数据总量不过数十万至百万小时级别。
落差本身就意味着空间。
报告中引用的海外实证同样佐证了数据的杠杆效应:当预训练数据体量接近翻倍时,任务完成率相应提升了约1.5倍——数据规模对性能的提升是可以被精确度量的。
AI研究者李飞飞也明确表态:虚拟仿真数据与实机数据之间是互补而非替代的关系,但后者承载的真实物理边界条件,是模型走向实际部署时不可绕过的关键一环。
正是在这种"数据极度匮乏"的压力驱动下,训练场这一全新类型的基础设施在中国率先跑通了规模化复制的路径。
从报告勾勒的空间分布来看,训练场已初步聚拢为长三角、京津冀、珠三角三大板块:浙江省以14家居首位,广东、北京、山东、江苏各拥有8座,四川5座,上海、广西各3座,湖北、安徽、湖南各2座,河南、河北、江西、吉林、天津、福建、重庆亦均有项目落地。
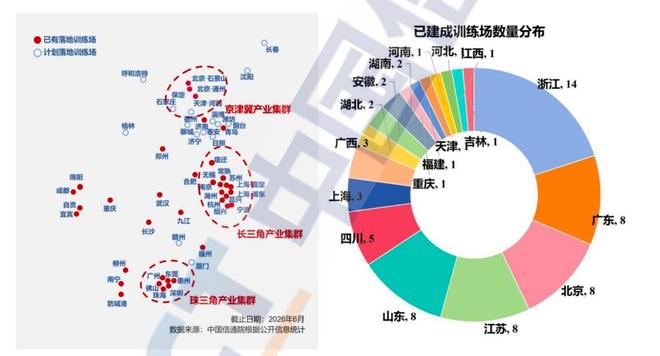
从北方的北京、天津及河北雄安新区周边,到中部的沪苏浙皖,再往南延伸到粤桂两广,一张横跨多个行政层级的数据基础设施网络已然初具轮廓。
仅在长三角区域,上海的麒麟人形机器人训练场、智元机器人的数据采集工厂、银河通用设在苏州的具身智能数据采集中心、杭州的人形机器人中试验证基地、合肥的具身智能机器人数据采集预训练场等项目加在一起,总占地便已超过7万平方米。
政策端的导向同样明确且密集。
工信部等八个部门联合印发的《"人工智能+制造"专项行动实施意见》中,专门提出打造人形机器人中试基地与训练场的要求;工信部携手国务院国资委启动了实景实战训练专项;国家发改委主张以训练场和中试基地为核心抓手,搭建高水准的真机数据采集体系,从根本上缓解具身智能训练环节的"数据贫血"难题;国家数据局则着手推进行业级高质量数据集的建设。自2024年起至2026年6月,各省市地方政府已累计出台超过40项配套政策文件。
数据采集中心绝非单一企业的"私活":智元、星海图、银河通用全员下场"攒数据"
有一个常被外部观察者忽视的事实:搭建数据采集中心,从一开始就不是哪家公司的"独家专利",而是整个产业的群体性行动。
按照建设和运营主体来划分,领跑者当属"国地中心体系"——由国家级平台北京人形机器人创新中心统筹,以上海主训练场"麒麟"为枢纽,串联北京、河南、深圳、河北、重庆、吉林、陕西榆林、江苏常熟及吴江等9个分站点,合计10处节点。
在企业阵营中,布局最为广泛的是智元机器人,其已在上海浦东及临港、成都郫都区、无锡、南昌、嘉兴、重庆、珠海、贵安新区等地落成或签署协议的数据采集中心与训练场共计9处;优必选、帕西尼感知、乐聚机器人各占5处,鹿明机器人有3处;京东、睿尔曼、银河通用、星海图、蓝思科技、卧安机器人、中联重科、群核、零次方、箸境、开普云、优奇等12家企业则各设有1处。
智元的运作方式颇具典型意义。
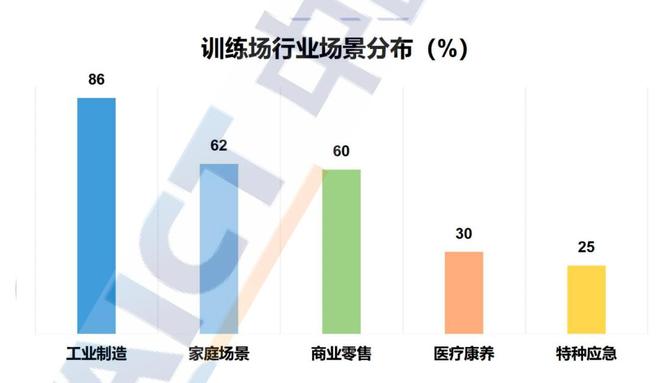
其坐落于上海浦东的数据采集车间还原了居家、餐饮、工业产线、零售卖场、写字楼等多种真实业态,内部布置了逾200种细分场景任务,涵盖3000余类可操作物件。除了满足自身研发需求之外,它还向业界公开了AgiBotWorld系列的实机数据集。
以上海张江的数据采集工厂为中枢,智元正向全国多家协作训练场输出标准化的数据采集方案,实现数据标准的统一和回流的归一,逐步构建起"行业伙伴协同共建"的格局。
在上海创智学院与智元联合披露的最新技术成果中,通过将机器人在真实环境中执行任务时的数据实时回流并用于模型迭代,长时序任务的平均子步骤评分相比传统的监督微调路线提升了将近五成——所谓"数据飞轮"的加速效果已被切实量化。
在深圳,智元携手玉禾田集团旗下子公司共建具身智能机器人智创中心,聚焦环卫清扫、物业保洁等垂直场景采集专用数据;在江西南昌的龙旗科技园区内,智元机器人已完成整条产线的端到端闭环作业。
其余参与者的切入角度各有不同。
星海图同样介入了人形机器人数据采集中心的搭建,跻身本轮数据基建的参与者行列。
京东则在双线并行:一方面联合江苏宿迁地方当局建设数据采集社区并开放第一人称视角数据集,另一方面推出了具身智能数据交易市场。
帕西尼在天津落成了面积1.2万平方米的大型数据采集工厂,预估年数据产出可达数亿条,并于当年5月完成了具身智能数据的合规跨境输出。
将这些名字排列在一起,结论不言自明:大规模数据采集并不是某家公司用来讲给资本市场听的概念,而是机器人产业为了自身进化不得不补齐的一堂基础设施必修课。
如果把机器人本体比作"躯体",把具身大模型比作"头脑",那么真实世界数据就是驱动二者协同成长的"教科书"与"营养液"——缺少教材,再出色的躯体和头脑也无法学会实际操作。
从"搭好架子"到"真正跑通":数据飞轮一旦咬合,红利将惠及全产业链
诚然,把训练场盖起来仅仅是起点。信通院报告并未粉饰太平,坦率指出当前训练场普遍面临场景任务雷同、实际数据产能偏低、跨机构流通不畅、可持续盈利模式尚不成熟等共性瓶颈,整个行业正从"大兴土木"阶段过渡到"能力积累"阶段。
但更具风向标意义的变化已经在发生。
在产能维度,报告预判已投运的训练场在2026年的数据年总产量将触及千万小时量级;经过规模化运营打磨后,真机遥操作数据每小时的边际成本已压缩至约275元,数据生产的工业化流水线正在成型。
在流通维度,2026年开春,全国首笔"具身智能数据集"挂牌交易在江苏省数据交易所完成交割;北京、贵阳等地的数据交易平台也相继推动相关品类上架;京东云、百度智能云、鹿明机器人等企业先后推出了数据撮合平台和"数据超市"产品。
在生态维度,上海麒麟训练场辐射带动了浦东张江模力社区聚集超过200家具身智能产业链上下游企业,"楼上楼下即供链"的产业微循环初现端倪。
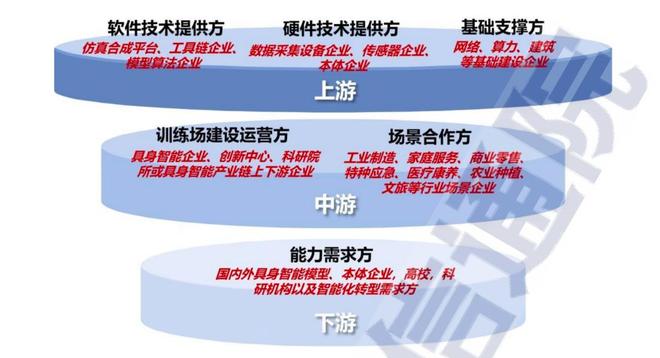
一个完整的技术-商业闭环正在闭合:机器人走进真实场景→产出真实数据→数据反哺模型训练→模型能力提升→更强机器人进入更广场景→催生更多数据。
当这架"数据飞轮"真正高速旋转起来,受益者绝不止于某几家公司,而是整条价值链——本体厂商获得了低成本试错的训练验证环境,模型厂商获得了稳定且高质量的燃料供给,