华为何庭波再度修订韬定律论文
本文篇幅约3589字,预计阅读需6分钟左右
撰稿人|第一财经 李娜
一枚在直觉上最该被高温"拖垮"的三维堆叠芯片,为何偏偏实现了更高的能效表现?
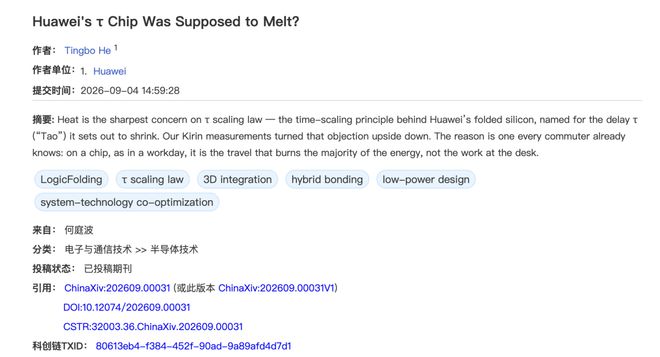
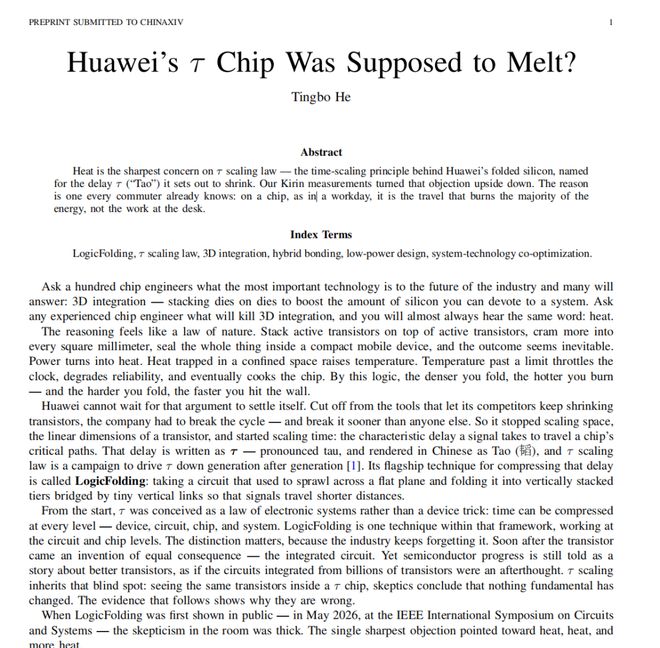
9月4日,华为半导体业务主管何庭波再度登录中国科学院科技论文预印本平台ChinaXiv,上传了一篇题为《Huawei's τ Chip Was Supposed to Melt?》的文章,旨在从芯片内部信号流动与电路架构的角度揭示这一反常现象背后的机理。
早在今年五月,华为便正式提出了"韬定律",意图为后摩尔时代半导体技术的延续开辟一条全新赛道。而本次论文的迭代发布,则是华为向外界系统阐释"τ芯片"如何借助电路拓扑的重构、信号通路的大幅缩减以及时延的有效压缩,把"沿时间维度的创新"落地为芯片在性能、能耗及温度控制方面的实质性跃升,同时也正面回应了业内关于"堆叠越密、发热越猛"的普遍担忧。
何庭波想表达的重点并非3D堆叠本身就等同于低功耗,而在于指出:以往业界审视芯片能耗时,目光往往过度聚焦于"晶体管运算"环节,却严重忽视了数据在芯片各区域之间流转时所付出的巨大能量代价。
"我们所能预见的τ的每一种未来形态,皆因功耗而成就,亦因功耗而受挫。时间裕度只是工具,能量才是真正的竞技场。未来十年衡量这条定律成败的标准,绝非折叠堆叠能跑出多高的速度,而是它们在疾驰过程中燃烧了多少能量。那枚按理应烧穿的τ芯片,最终却以更低的温度运转——不是因为它被折成了层状才降温,恰恰是因为'折叠'这件事本身。说到底,τ(韬)的应用场景远不止于此。"这是何庭波在文中的原话。
按理说应该更烫,凭什么反而更省?
从何庭波的论述来看,倘若你问一位芯片工程师,行业未来最关键的攻关方向在哪里,"三维集成"大概率会收获最多的点头;可若再追问一句,什么因素可能会成为3D集成的终极瓶颈,不少资深从业者不约而同地指向同一个词——"热"。
道理其实并不晦涩。在同等面积内塞入更多晶体管,必然导致单位面积的晶体管密度攀升,由此产生的电能终将转化为热能;而在垂直堆叠架构下,底层晶体管释放的热量还必须穿透上方的封装材料才能逸出。一旦散热跟不上节奏,芯片温度便会攀升,进而拖累工作频率、推高功耗并侵蚀器件寿命。
正因如此,在何庭波勾勒的传统发展轨迹中,3D堆叠似乎天生背负着一对悖论:尺寸越小、晶体管越密集、堆叠层数越多,热设计的负担就越沉重。
然而何庭波指出,这里藏着一个极易被人忽视的事实:芯片所消耗的能量,并非仅仅产生于"运算",还有相当一部分消耗在"搬运"上。
她在文中打了一个颇为生动的比方:一个人一整天花掉的体力,大头并不是坐在工位上敲键盘的那几个钟头,来回通勤同样要消耗可观的能量。芯片的逻辑如出一辙——晶体管执行逻辑操作固然耗能,但数据在晶体管之间、功能模块之间乃至不同电路层级之间长途跋涉,同样在默默吞噬电量。
据文中所述,在一部典型智能手机的日常使用场景中,动态功耗大约占到整机总功耗的九成左右;而动态功耗的构成里,除了晶体管的开关翻转之外,还包含电信号在金属走线中传播的部分。随着工艺节点不断微缩,互连电容对能耗的贡献日益显著,在某些工况下,真正"烧钱"的并非晶体管在做"思考",而是数据在芯片内部反复"上下班"。
LogicFolding正是瞄准了这一痛点展开设计。
何庭波强调,τ定律绝不是把芯片简单地切成几片然后摞起来,而是要从根本上改写信号的传播路径。在传统平面芯片里,若干关键互联不得不横向穿越很长的距离;而LogicFolding的做法是将部分电路拆分为上下两层布局,把原本冗长的水平走线转化为更短的垂直通道。
文中提到,在若干典型处理器核心中,这种方案可将平均连线长度削减约两成,关键路径上个别走线的缩短幅度最高可达七成。以一个具体的处理单元为例,时钟网络布线长度缩减了28%,时钟缓冲器的用量也从大约4.36万只降至1.9万只。由此可见,所谓的"折叠"绝非粗暴地将晶体管往上堆,而是对晶体管之间的空间关系做了一次重新编排:尽量别让数据绕远路。
τ究竟在颠覆什么?
2026年5月,何庭波在IEEE国际固态电路学术大会的相关论坛上首次面向公众详细解读了τ定律与LogicFolding。华为方面此前透露,已有数百款芯片依据τ原则完成了设计与批量生产,并计划于2026年秋季面世首款搭载LogicFolding工艺的麒麟系列SoC。
不过,真正引人深思的并非"折叠"这一物理动作,而是华为能否持续证明该方法确实能在性能、功耗和集成密度三个维度上兑现实际收益。
何庭波在文中公布的第一批实测数据源自麒麟2026。按其披露,该芯片的晶体管密度由先前的每平方毫米约1.55亿颗跃升至2.38亿颗,增幅约为55%。在保持输出性能不变的前提下,NPU功耗削减了66%,GPU下降了58%,CPU高性能核心降低了41%。
其中NPU的表现尤为亮眼:在维持29 TOPS算力的同等条件下,工作频率下调了63%,供电电压由0.85伏压低至0.55伏,最终功耗缩水66%,功耗密度更是骤降73%。GPU也遵循了类似的优化逻辑,在锁定61帧每秒的画面输出时,电压拉低了约200毫伏,功耗随之减少58%。
但何庭波并未将LogicFolding包装成一项"一折必省"的万能公式。
DSP模块便是一个反例。初代折叠方案中,完成同等任务的绝对功耗虽降低了25%,可由于芯片占地面积缩减了四成,折算后的功耗密度反而上浮了24%。文中补充道,到了麒麟2027的DSP版本,上述短板已被修正,功耗降幅扩大至47%,功耗密度也回落到原始平面方案之下。
这恰恰说明,τ定律要破解的从来不是一个单纯的"怎么省电"的命题,而是为芯片设计师打开了一扇重新调配性能、版图面积与功耗三者比例关系的窗口。
然而,最大的不确定因素依然是功耗本身。这也是何庭波在本文中着重划出的一条边界:τ是一条时间缩放法则,而非能量缩放法则。
芯片转速加快,绝不等于它一定更"省油"。反过来讲,假如设计团队把通过缩短信号路径省下的时间余量悉数拿去拉升频率、榨取峰值性能,芯片的总耗电完全有可能不降反升。
所以,LogicFolding真正的价值在于,把那些省出来的"时间"兑换成其他维度的红利。例如,软件层面可以通过加大并行任务占比来压缩串行瓶颈;硬件层面则可以借机增设并行计算单元、精简数据通路,从而同步压低延迟与能耗。
NPU便是最佳注脚。何庭波介绍,上一代架构中采用了一颗大核搭配两颗能效核的组合;LogicFolding腾出的晶体管预算被用来扩充计算核心的数量,最终构建出更宽幅的并行阵列,在更低的电压水平下即可达成更高的吞吐量。
但同样的策略移植到CPU上就没那么顺风顺水了。
CPU承载的大量任务带有强烈的顺序依赖特征,没法靠单纯复制更多核心来化解。因此文中呈现的数据也印证了这一点:CPU高性能核心所获得的收益明显逊于NPU和GPU。何庭波判断,这一领域仍需更精密的微架构设计、更成熟的EDA工具链支撑以及漫长的流片验证周期,后续的探索空间仍然非常广阔。
下一关真正的硬骨头在哪?
LogicFolding固然有效缩短了数据搬运的距离、降低了若干子模块的功耗,但3D结构固有的散热难题并不会因此烟消云散。底层硅片散发出的热量依旧要沿着上层结构向外传递。
何庭波对此给出的解读是:评估热问题不能只盯着芯片的总产热量,更要关注热量究竟聚集在哪些区域,以及每个晶体管的结温处于什么水平。
在同等性能指标下,如果LogicFolding成功压低了整体功耗,那么全局的热负担自然会减轻;与此同时,通过调整各功能模块的空间排布,可以让高发热模块彼此错开,防止多个热源在同一垂直轴线上叠加。
文中透露,麒麟2026采取的是一套较为稳健的策略——并非将所有电路无差别地垂直堆上去,而是优先对关键路径实施折叠,并辅以热感知的版图规划。
换言之,"芯片本该烧毁却反而更凉"的背后,并不是3D堆叠突然攻克了散热魔咒,而是设计者力求从源头上削减需要被消耗的能量总量,并对热量产生的空间分布做了精心调度。
当然,这份收益绝非零成本。
混合键合的对准间距、上下层间的机械应力、化学机械抛光与清洗工序、晶圆翘曲控制、套刻精度,以及愈发复杂的EDA建模与签核流程……这些都将成为τ路线继续前行时必须逐一攻克的工程难关。何庭波在文末预判,未来三到五年间,这条路上仍将有大量的未知等待去填补。