AI集群越大,算力利用率为何不升反降?华为灵衢互联架构给出解法
近年来,业界讨论的热度一直停留在单颗芯片的速度、算力数值以及制造工艺层面,核心逻辑就是"谁的主频更高"。但随着大模型参数量不断膨胀,特别是MoE(混合专家架构)、Agent(智能体)和超长上下文推理逐步成为行业标配,算力竞赛的重心正在发生根本性转移——不再是某一颗芯片能跑多快,而是能否把海量的计算、存储与网络资源有机整合,形成一套高效的系统级能力。如何切实提高计算系统中有效算力的利用水平,已成为摆在面前的核心难题。
"在传统的计算体系里,集群越大,资源利用率反而越容易走低。一个十万卡级别的集群,其真实模型算力利用率往往只有两成左右,相当一部分硬件资源并没有在做有效的模型运算,而是在空等通信结束。"9月17日,华为常务董事兼ICT BG CEO杨超斌在华为全联接大会2026上指出。与此同时,万亿参数级别的大模型训练会生成巨量的中间状态数据,单张卡的显存已无法容纳;而步入Agentic AI阶段后,Agent与底层模型之间每小时可能产生数百轮交互,这又大幅推高了CPU、NPU、内存与存储彼此间的数据搬运压力。
换句话说,当AI集群从千卡级迈向万卡、十万卡乃至百万卡量级时,竞争的维度已经从单一计算单元的峰值表现,拓展到了整条计算链路的协同效能:既要回答"总算力够不够",更要回答计算、内存、存储与网络这些异构资源怎样被高效地串联起来,让如此庞大的硬件阵列真正像一个整体那样运转。
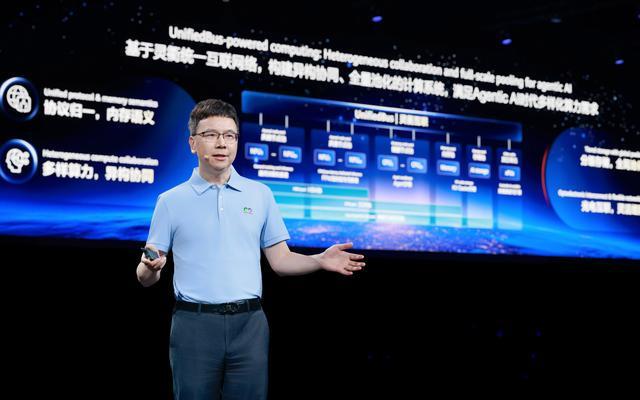
正是基于这一判断,杨超斌在会上完整阐述了华为面向Agentic AI时代的全新计算架构方案:以灵衢互联为中枢,构建"集群+超节点"的新型计算范式,将CPU、NPU、DPU、DDR、SSD等各类计算与存储组件纳入统一的互联框架并实施分级池化管理,从而实现多元异构算力的灵活调度与高效协作,从容应对未来业务形态的演变,并为新型异构算力的即插即用式扩展留出空间。同期,华为还正式推出了涵盖柜内、跨柜及集群三个层面的灵衢互联产品线,以及基于灵衢打造的Agentic AI超节点集群和系列化一体机算力平台。
**从"堆芯片"到重塑计算系统**
扩充AI集群最直觉的做法就是加卡。但当卡片数量攀升到千张、万张甚至十万张时,一系列新问题随之浮现:每张卡本身都有算力,却必须不停地跟其他卡同步参数和中间结果。一旦通信速率追不上计算速率,越来越多的时间就被耗费在数据搬移和排队等候上。
华为副董事长、轮值董事长汪涛披露了一组关键数字:在一个由8卡服务器搭建而成的十万卡集群中,模型训练期间集群内部的通信耗时超过了总训练时长的四成,严重拖累了MFU(模型浮点算力利用率)。华为马尔可夫实验室的仿真数据还表明,在同等十万卡体量下,采用4K规模超节点组建的集群,其MFU可以达到传统8卡服务器集群的2.75倍。汪涛强调,MFU每提高一个百分点,模型的迭代周期就能缩短大约三天。
由此可见,当集群迈入十万卡乃至更大规模后,真正紧迫的课题早已不局限于怎样把更多的计算卡"塞进"同一个集群,而是要让它们彼此之间真正实现高效率的协同工作。
这正是华为此次亮出新计算架构的初衷所在。在杨超斌的描述中,灵衢(UnifiedBus)是整个架构的中枢互联技术。区别于传统服务器中CPU、加速器、内存、存储各自走不同协议的"各管一摊"模式,灵衢首先要做的事情就是将十几种互联协议归拢为一套统一标准。在这一架构之下,互联带宽可从百GB量级跃升至TB量级,RTT通信时延由7微秒压缩到2微秒,并且支持超节点范围内全局内存的统一寻址。
不过,统一协议和带宽升级所回应的仅仅是"数据怎样才能跑得更快"。在以单台服务器作为资源边界的传统架构中,CPU、NPU、内存等物理资源一般按整机规格配齐,上线后数量和搭配基本锁死。哪怕不同的AI任务对各类资源的需求差异很大,计算资源也难以依据实际负载进行动态重组。
而在灵衢架构中,CPU、NPU、内存、SSD等不同类别的计算、存储与网络设备之间可以直接互通,实现去中心化的对等访问,CPU与NPU也能根据具体计算任务的特征进行更为弹性的资源调配。
这种转变在Agentic AI场景中表现得尤为突出。以往的大模型主要承担问答和文本生成,而Agent还需要执行任务拆解、外部工具调用和多步骤循环操作。这就意味着,一道任务可能在CPU、NPU、内存与存储之间来回穿梭,对各类计算资源的需求也在持续波动。
面对这一现实,华为提出了AF分离部署策略。Transformer的主体由Attention(注意力模块)和FFN(前馈网络)等部分组成,但两者所承担的功能以及对底层资源的诉求存在显著差异:Attention侧重于捕捉不同Token间的上下文依赖关系,且随着序列拉长,其对访存带宽和数据交换的要求会急剧上升;FFN则集中处理大量的特征映射与矩阵运算。
此前,Attention和FFN通常在同一套硬件上顺序执行;华为则借助分层分级的Transformer硬件加速手段将两者彻底解耦,分别安置在不同的算力单元上,再依据各自的计算特性匹配对应的资源配置。如此一来,CPU与NPU不再受限于固定的服务器配比,而是可以针对不同业务、不同推理阶段的具体需求自由组合,从而同时改善推理吞吐和资源利用水平。
如果说AF分离回应的是"异质计算任务怎样更自如地获取算力",那么随着模型体量持续膨胀,灵衢还需攻克一个更为底层的命题——计算过程中涌现的海量数据到底该往哪里放。
模型参数规模和上下文窗口不断拉伸,带来一个非常现实的瓶颈:数据"放不下"。尤其是在推理环节,KV Cache随上下文增长会快速吞噬内存空间;万亿参数模型训练所产生的中间数据,也让单卡HBM的容量捉襟见肘。
华为给出的方案是分级存储与全局池化,借助不同存储介质之间的资源共享来拓宽整个计算系统可调度的地址空间。举例来说,DDR可以被当作NPU的"外挂二级缓存"。杨超斌介绍,在搜索、推荐、广告等典型业务中,该架构能够有效压低端到端时延,并将千亿规模、数千维度的向量检索性能提升一倍以上;在万亿参数大模型训练中,则能缓解单卡HBM的容量瓶颈,进而拉升整个集群的MFU。
至此,灵衢的定位逐渐明朗:它绝非简单地用线缆把更多计算卡串在一起,而是力图通过统一互联,把原先各自为政的CPU、NPU、内存、存储与网络重新编织成一个有机的计算整体,辅以分级存储和全局池化机制,让整套超节点能够尽可能像"一台巨型计算机"那样对外提供服务。
**从柜内到集群,灵衢搭建三级互联体系**
当单个超节点继续向数千卡、数万卡乃至百万卡方向延伸时,仅靠打通超节点内部的互联通道远远不够。如何让这套架构突破机柜边界,一路扩展到数据中心级别的超大规模集群?
华为的思路是将灵衢从超节点内部的互联手段升级为覆盖柜内、跨柜、集群三个层次的分层互联体系,逐一应对不同距离、不同层级上的数据交换需求,最终支撑从单柜到百万卡集群的平滑、弹性扩展。
在单个机柜内部,服务器间距虽短,但芯片密度持续走高,传统布线方式愈发难以维护。为此,华为推出了柜内灵衢互联刀片,采用光电融合互联方案大幅削减线缆用量。据华为透露,该刀片可实现"零电缆、零线路损耗"。以4096卡超节点为例,仅此一项便可省去约196公里的铜缆。
当超节点从单机柜延伸到多机柜后,传输距离拉大、数据流量激增,互联链路既需要更高的带宽,也必须严控通信延迟。本次发布的跨柜灵衢互联设备提供176个端口,单端口带宽达1.6T,单机即可实现280T的全光互联,RTT时延最低压至2微秒,能够将散布在不同机柜中的计算资源无缝拼接为一个更大的统一计算体。
除了互联硬件本身,华为还在围绕这套架构搭建更完备的算力生态。会上,华为正式发布基于灵衢的A