明略科技(2718.HK):万亿级大模型“瘦身”登陆PC端
近年来,人工智能领域最显著的趋势之一,就是持续将模型规模和能力推向极限。然而,当这些模型被嵌入到Agent系统及复杂的工作流程中后,一个棘手的矛盾逐渐显现:模型越强大,所需的Token量越大,推理开销正日益成为AI大规模商用化进程中无法回避的核心难题。
这一现实促使整个行业的目光逐步转移——不再仅仅追问"模型上限在哪里",而是开始探讨"这些能力最适合在哪一层执行"。云计算仍是核心阵地,但终端侧AI正开辟出全新的可能性:倘若最先进的模型不再局限于服务器机房,而是能直接运行在每位用户的日常办公设备上,格局将会如何改写?
这绝非简单的模型"瘦身"。如何在模型结构上做选择与裁剪、如何匹配底层硬件、推理引擎又该如何重构,每一项都要求从零开始重新架构。
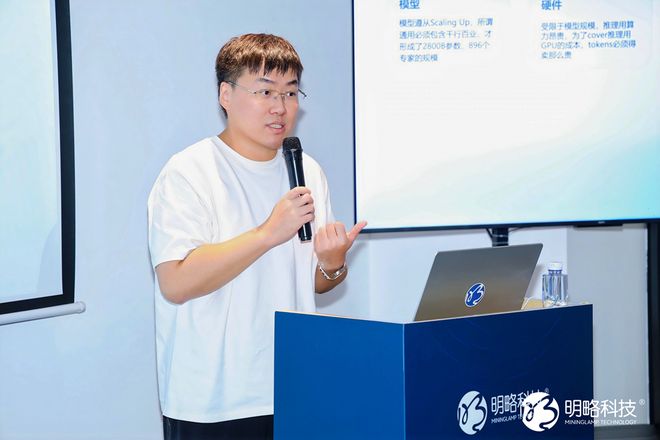
明略科技副总裁兼多模态首席科学家赵晨旭在一次内部战略研讨中,系统阐述了他对终端侧模型创新的理解。围绕"Scaling Out"这一路径,他尝试回应一个根本命题:怎样让最前沿的AI能力走出云端数据中心,真正抵达每个人案头的设备。在他看来,这可能标志着终端AI从"勉强驱动小型模型"向"流畅承载大型模型"的一次根本性跃迁。
图片来源:明略科技
以下为节选内容:
模型性能持续提升的背后,是Token消耗和算力支出的同步攀升。不妨换个视角来审视这个问题:假如某天,类似Fable 5这类顶级旗舰模型被无条件开放源代码,世界会怎样?
这并非纯粹的科幻推演。当前已涌现出性能逼近该水准的开源方案,例如Kimi K3。团队近期也进行了实测,依托明略科技搭建的大规模Web Agent综合能力评测体系WebRetriever,K3在最苛刻的第三层协议上已跻身榜首。
换言之,"是否存在能力比肩顶级闭源系统的开源替代",这个问题正逐步获得肯定回答。紧接着的新议题浮出水面:模型即便开源了,我们是否真有能力将其投入使用?
以K3为例,其完整的MoE参数量约达2.8万亿,激活参数亦处于千亿量级。对一般企业乃至个人用户而言,"开源"二字远不等于"可用"。因此我判断,未来一段时期内AI领域或将迎来一个颇具意味的转向:此前我们执着于把模型做大,下一步或许要着手思考,怎样将这些已然足够强悍的模型进行精简、拆分,最终装进我们自己的电脑。
这正是我们当下聚焦终端模型创新的逻辑起点。
从前攻克的是"如何把模型做大",如今面对的课题是"如何把模型真正用起来"
图片来源:明略科技
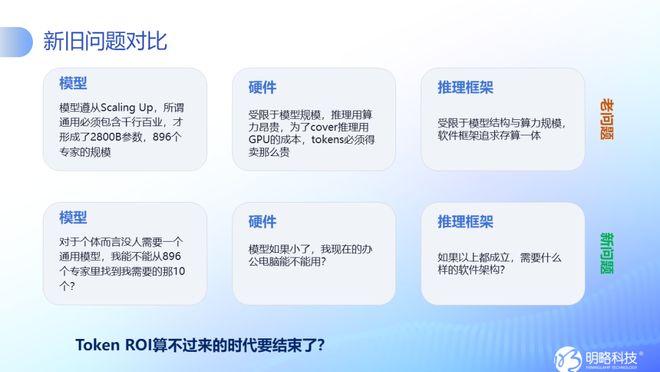
回顾近几轮大模型演进,始终围绕着三条轴线展开:模型本体、底层硬件、推理引擎。
就模型而言,业界沿袭的是Scaling Law,一路向上堆叠。参数膨胀、数据扩充、训练算力加码,能力随之水涨船高。为何必须做到如此庞大?关键在于,这些模型面向的是全球各行各业的海量使用者。一套通用体系既要支撑金融分析,又要赋能研发工程师,还得兼顾编程、检索、办公协作、科学计算等多元场景。要覆盖如此宽泛的数据分布与任务谱系,引入海量专家节点便成了必然选择。
正因如此,单一模型坐拥数千亿参数、数百乃至上千个专家模块,自有其内在逻辑。
但换个角度想:站在某个具体从业者或某家具体企业的立场上,真的有必要调用全部这些专家吗?
大概率不必。一位金融分析师主要依赖的是金融垂直领域的推理能力;一名软件工程师则更看重代码生成、网页检索或AI辅助科研等功能。对某一特定用户而言,真正有用的可能仅仅是庞大模型中的十几位、几十位专家。
若从个体或企业的真实工作流切入,所需能力往往只是全集的一个子集,那么核心问题便转化为:能否从一座庞然大物中,精准抽取"与我相关"的那一小块能力?
一旦模型得以瘦身,第二个挑战随即浮现:它能否顺畅运行在日常办公所用的PC之上?倘若现有PC的算力、显存和内存配置并不天然契合,我们能否借助新型硬件方案与推理架构,让它切实跑通?
由此可见,当前的核心命题已与数年前截然不同。彼时的疑问是"如何造出更大的模型",如今的焦点变为"如何将已然够强的模型送到用户触手可及之处"。只要模型架构、硬件适配、推理框架这三道关卡都能打通,Token投入产出比的逻辑也将随之重塑。
借助Scaling Out,在缩减模型体积的同时如何保住专家能力?
提到"做小",多数人的直觉反应是蒸馏。蒸馏固然是条成熟路线,但此次我们提出的是另一条思路——Scaling Out。
Scaling Down(即传统蒸馏)的目标是在维持模型通用性的基础上实现体量压缩,代价是削弱单个专家的深度表现,但尽量维系原始的数据分布与专家配比。
Scaling Out的哲学则有所不同:它主动放弃部分数据覆盖面和专家广度,换取留存专家的单体能力几乎不受损。
图片来源:明略科技
可以将原始大模型比作一片广袤的圆形区域。Scaling Down相当于将整个大圆等比例缩成一枚硬币大小的圆;而Scaling Out则更像是从这片大圆中,精确摘取与你真正关联的几枚小圆。
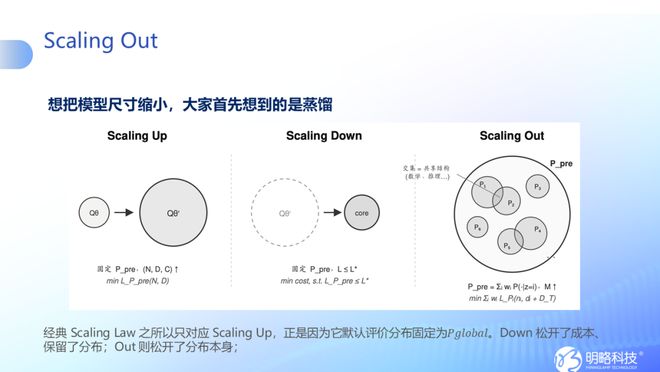
因此,这一步的关键不再是机械地压缩参数,而是要先厘清一个前置问题:针对特定用户群体、特定企业、特定业务情境,究竟哪几位专家才是不可或缺的?
这意味着Scaling Out的首要动作并非训练,而是"读懂用户"。我们需要依据使用者的身份、日常工作内容和典型任务,量身构建对应数据集。随后将这些任务输入足够庞大的基座模型,借助其固有的路由调度机制进行观测:在执行各类任务的过程中,实际唤醒了哪些专家节点。譬如编码类任务可能高频触发若干Coding专家,而网页检索类任务则倾向于激活另一组专家。
当海量任务遍历完毕,便可量化各专家的被调用频率、功能特异性,以及哪些任务必须依赖多位专家的协同配合。最终产出的不是一套"万能模型",而是一个锚定具体用户与具体企业任务的最精简专家组合。
原本或许是万亿级参数、千万级专家的全景图,经此筛选后,可能仅保留其中一小簇。再围绕这一新专家组重新规划路由策略、开展定向训练与微调,便能锻造出一个高度贴合特定场景部署需求的轻量化模型。
归根结底,Scaling Out要回应的并非狭义的"模型压缩",而是一个更本质的追问:通用大模型中,有多少能力对我而言纯属冗余?能否只携带我真正需要的那部分能力,且最大限度保有其原有水准?
这也构成了我们眼中Private AI落地的关键技术底座。展望未来,一方面仍会有人追逐更强、更通用的AGI方向;另一方面,面向企业与个体的Private AI生态也将日益丰富。它们无需背负整个世界的全量知识,只需掌握自身切实需要的那一小片专家版图即可。
模型瘦身之后,如何让普通办公PC真正承载起来?
模型缩小仅是序幕,紧随其后的硬约束是硬件。
当下消费级PC正处于一种颇为微妙的状态:部分机型算力充裕却显存捉襟见肘,另一些机型内存宽裕却缺乏驾驭大模型的GPU算力。正因如此,目前用普通电脑跑4B、8B参数的小模型已司空见惯,但若告知大家一台常规办公PC也能驱动120B量级的模型,并且能在完全断网的条件下完成复杂的编码任务,恐怕才真正令人振奋。
这一点我们已在真实设备上完成了验证。在一台标准配置的电脑上,我们成功部署了SOTA级别的大语言模型。同时将明略自主研发的人员与Agent智能协作平台Octo以及OpenAI的Codex接入该本地环境,直接将网络连接切断,模型依然能够在本地独立完成任务闭环。
这一实践折射出一个深层转变:终端AI的准入门槛,正从"手里有没有一张高端GPU",逐步过渡到……